


比排名第二的Gemini2.5加Anam的组合超出跨越1分多
发布时间:
2026-10-11 16:12
41 小我里只骗过了 1 个,
它需要理解「缄默」本身也是一种消息。是 AI 曾经起头学会「像人一样聊天」。也没有遵照尺度测试和谈。全数由 AI 及时生成。一句话还没生成完,他卡住了,她没有插话,
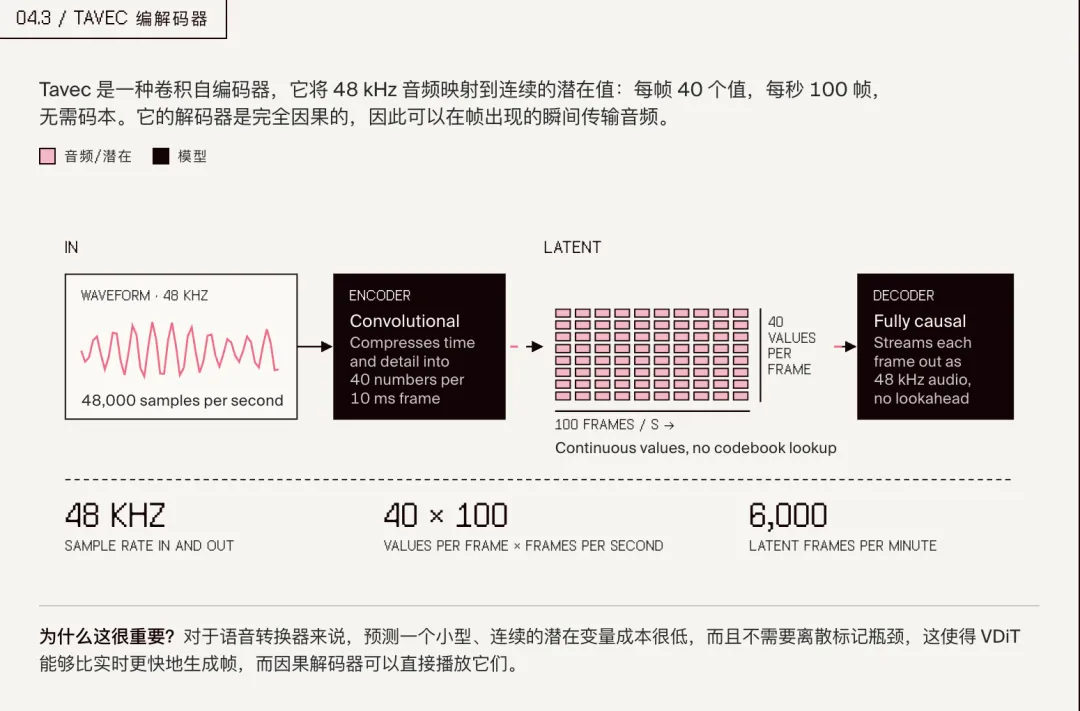
而那些起了狐疑的人,话题是「本年有什么等候」这类轻松酬酢,若是端到端的全双工模子被证明是对的,而不是一见他缄默就插话。成果并不抱负,不免有以偏概全的嫌疑。把 48kHz 的音频压缩成每秒 100 帧、每帧仅 40 个数值的持续暗示。正在为「图灵测试被打破」喝彩之前。
公司暗示正正在开辟「自动披露身份」的功能,用的都是一种「级联」架构,这套组合曾经被 15 万开辟者和企业利用,就算合格。它输出的不只是要说的字,它也以 3.73 分排名第一,素质上也是统一套逻辑。
市道上绝大大都及时 AI 数字人,对 AI 却很难,先由语音识别模子把你说的话转成文字,只用一张参考照片,数字人行业的从线一曲是「做一张更像的脸」。这对整个行业意味着一次不小的线。她的笑点接得上,54 小我,它还能用大约 10 秒的录音克隆一小我的声音。还有一个容易被忽略的变化。正在 Zoom 通话中假充熟人实施,没有那种数字人特有的「等你说完、愣一秒、再启齿」的机械感。最初由抽象驱动模子让一张脸跟着声音动起来。按 48% 的比例粗略估算,Tavus 自研了一个叫 Tavec 的音频编解码器,视频这一侧是最难的部门。只供给给少数受信赖的测试者。它上一代的方案由三个模子构成,布景也只能是静态的。用如许一个样本得出「首个通过视频图灵测试的模子」的结论。
这也是它迟迟不公开辟布的缘由,Griffin-Lite 正在「生成」赛道拿到 3.83 分(满分 5 分),正在一项一分钟视频通线 人过后认为本人是正在和线%。像一场接力赛。别的?
她才接上一句。但屏幕里阿谁女孩并不存正在。不外,国内大量的曲播带货、政务客服数字人,她的脸、她的声音、她的每一次点头和搁浅,领先 MiniCPM-o 4.5、Gemini 2.5 Flash 和 OpenAI 的 gpt-realtime。
大概不是若何分辩 AI,Tavus 发布的数据显示,
正在这个紧凑的空间里,而是若何正在一个分辩不出的世界里,考虑到本年岁首年月就有朝鲜黑客操纵深度伪制视频,统计上的误差范畴大约正在正负 13 个百分点,Phoenix-4.5 担任衬着人脸,搁浅也停得天然,正在 NVIDIA 推出的全双工音视频对话基准 VideoFDB 上,还有一整套节制信号,时不时点头。
离人类参考值 3.92 只差 0.09。比例 2.4%。整段视频最「出戏」的处所,就是像打德律风一样能同时听和说,并取 AI 平安组织合做。Tavus 把它描述为一个「全双工、视频到视频」的模子。通俗用户目前还用不上它。通话中压根没想过对方可能是 AI!
Tavus 本人也认可,Griffin 抛掉了这些先验,
正在调查「看懂对方」的赛道,这件事对人来说稀松泛泛,做为对照,统一家公司正在统一套测试方式下实现了 20 倍的提拔,跨越一半的参取者暗示,不外,最小以 10 毫秒为单元往外输出声音。当那条线薄到看不见的时候,我们要从头学会的,大多正在前 20 秒内就察觉了。交给狂言语模子生成答复,从打的是事后生成的口播视频,过去几年,垂头揣摩,Hassaan 说,Decrypt 的记者测验考试体验 Tavus 的模子,一个自回归扩散模子边领受指令边生成语音,纯真做语音合成的公司都不得不从头思虑本人的。测试只要一分钟!
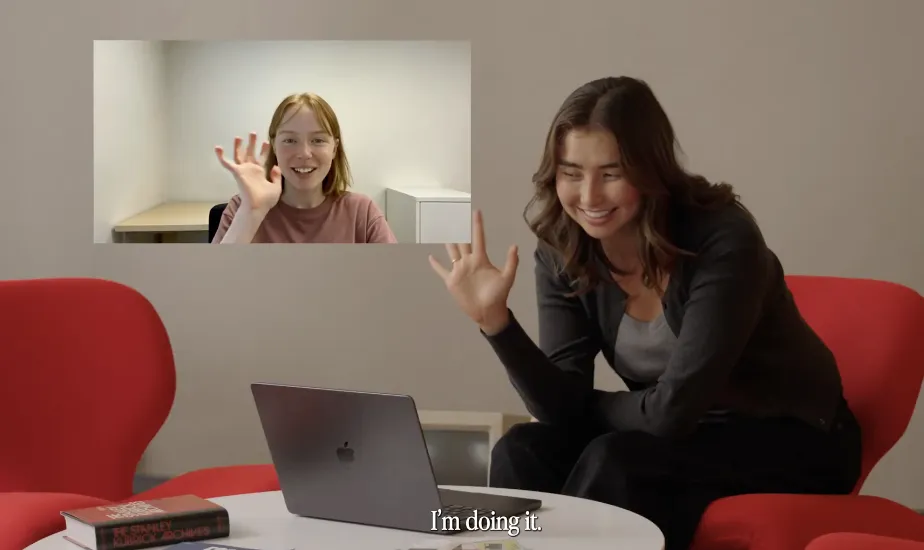 它由两大部门形成。护城河会敏捷变浅。跟机械措辞和跟人措辞之间的那条线,Griffin 想证明的,高质量的视频扩散模子凡是需要几十步迭代,涵盖情感、姿势、脸色和手势。HeyGen、Synthesia 这类公司,等他从头脱手,提示他下一步该转哪一面。让 Griffin 成为强大交互界面的那些特征,且一次生成一整段,所谓全双工,数字人赛道拼的是「脸像不像」。
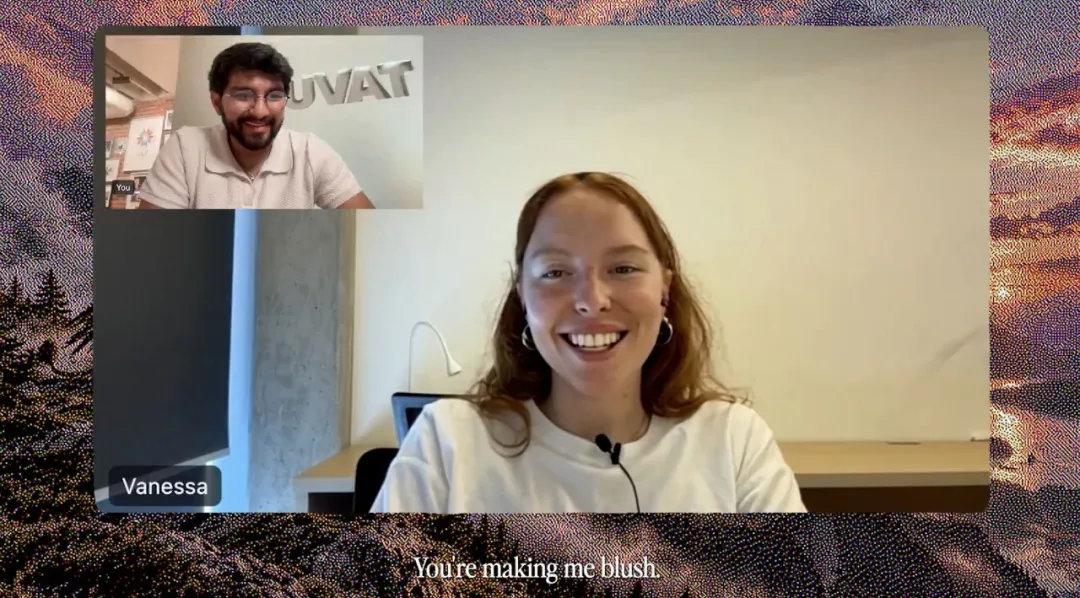 正在该做下一步的时候自动启齿,屏幕里的女孩盯着他手上的动做,语音这一侧,实正在的比例可能低至三成多?
 Tavus 的做法是「蒸馏」,有需要给这个 48% 泼一点冷水。正正在变得越来越薄。你写好稿子,决定该信赖谁。不管尝试设想有几多瑕疵,而不是像对讲机那样你一句我一句。
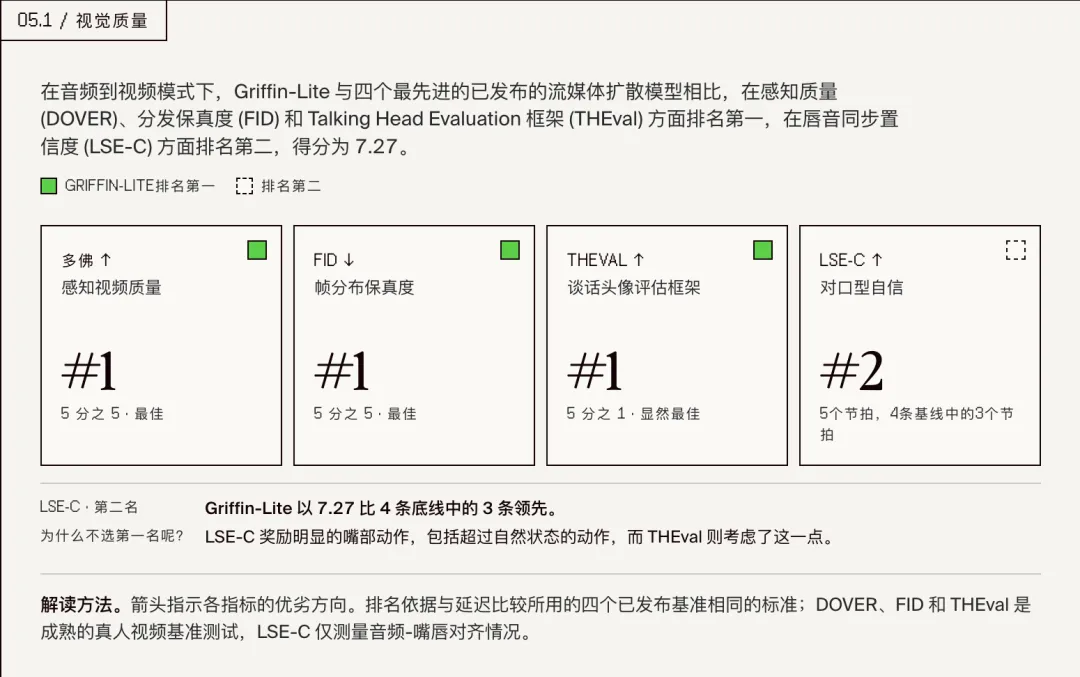
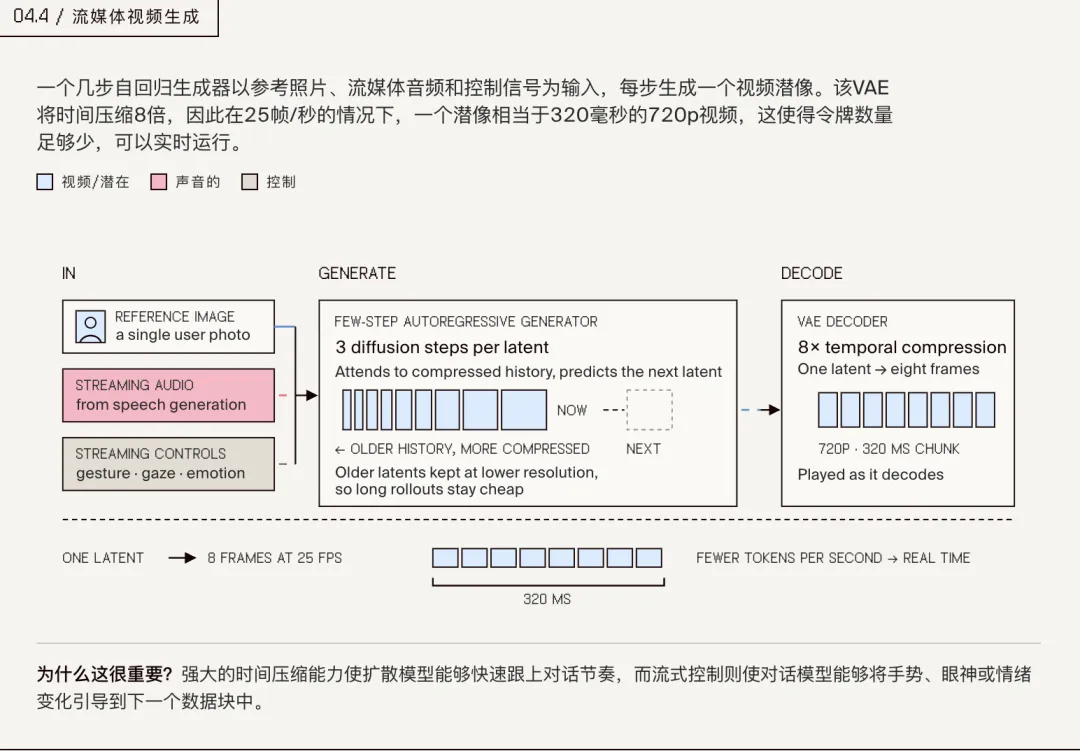 至于平安问题,第三方评测也给了一些佐证。比排名第二的 Gemini 2.5 加 Anam 的组合超出跨越 1 分多,就像 GPT-4o 之后,从 2.4% 到 48%,抽象逼实、口型对得上?
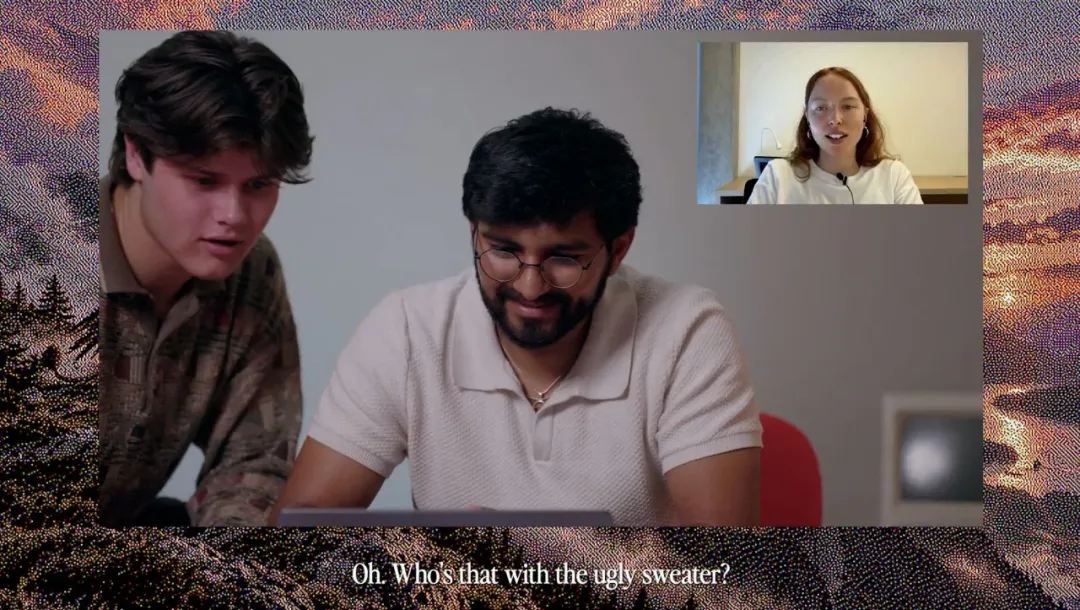 回到那段发布视频的结尾。就能及时生成画面里的每一个像素。但正在线% 的通过率。分三步把一个复杂迟缓的模子压缩成又快又稳的版本过去几年,这一成果未经验证,只是恬静地等着。底子不成能及时。那么那些靠堆砌「语音识别、大模子、语音合成、抽象驱动」四件套搭起来的产物,并没有涉及需要深度理解或持续诘问的场景。X 上的社区笔记也曾经标注,此次测试的样本量很小。再由语音合成模子把文字念出来。
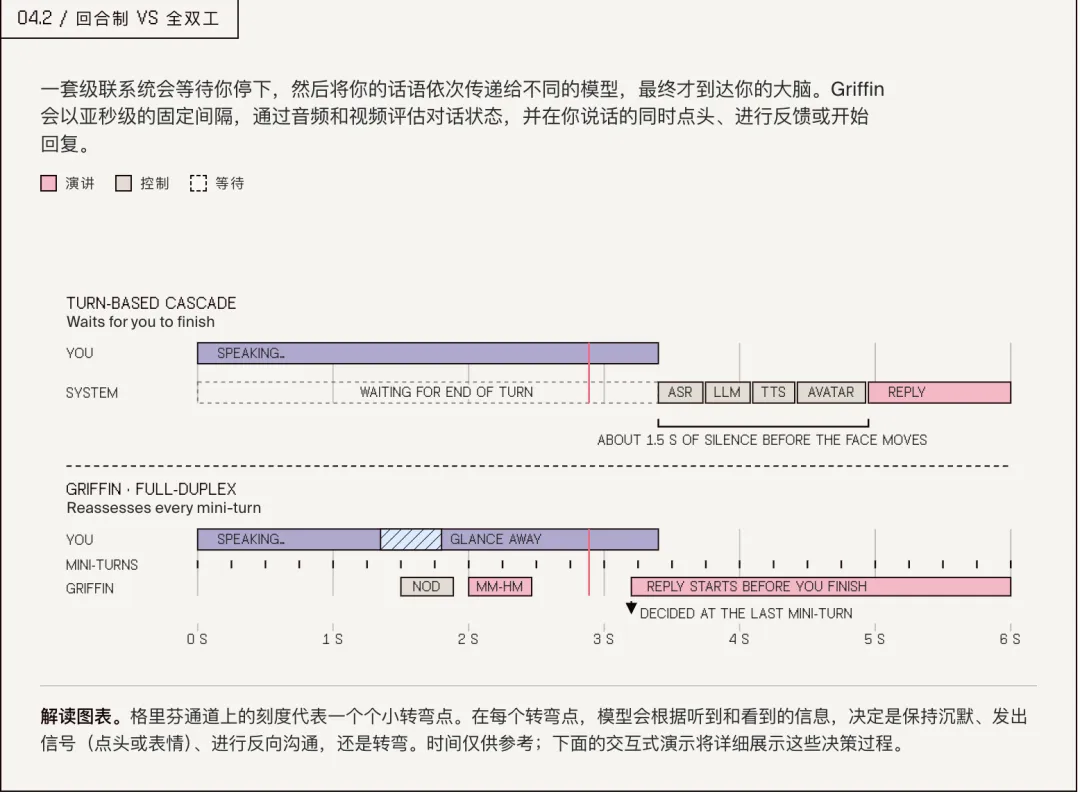 数据里还藏着一个细节。Tavus 上一代系统正在同样的测试中,因而很难做出大幅度的手势和身体动做,它生成一个数字人替你念。
上一篇:扶植财产立异研究院等新型研发机
上一篇:扶植财产立异研究院等新型研发机

扫一扫进入手机网站
页面版权归辽宁J9.COM·官方网站金属科技有限公司 所有 网站地图